PDF Markdown変換ツール比較(2026年最新)— 数式・表・スキャン対応の10選
KomoAI LLC · 更新日 · 初公開 · 9 分で読めます
結論から言うと: 単段組のデジタル PDF から手早くテキストを取り出すだけなら、無料の pdf2md.morethan.io や pymupdf4llm で十分です。一方、2段組の学術論文、LaTeX 数式、セル結合のある表、脚注、スキャン PDF を扱う場合、テキスト層だけを読むツールでは読み順や数式が崩壊します。ローカル運用なら Docling(MIT・CPU可) や Marker / MinerU(GPU推奨)、GPU 環境を構築せずブラウザ・REST API・AI エージェントからそのまま高精度に出力したいなら KolmoPDF PDF Markdown変換 が最も実用的な選択肢です。
注記: KolmoPDF は当社が提供するサービスです。エアギャップ環境や自社 GPU での大量バッチ処理など、オープンソース(Docling・Marker・MinerU)や数式特化ツール(Mathpix)の方が適しているケースも本記事内で正直に記載しています。
実ファイルで今すぐ試す: 公開テスト論文(original.pdf)と KolmoPDF の実際の変換結果(original.md)を比較できます。Web での変換は PDF Markdown変換ツール から、そのままのレイアウトで翻訳したい場合は PDF翻訳 から試せます。
PDF Markdown変換ツール 10選 比較表(2026年11月)
| ツール | 方式 | 実行環境 | 2段組の読み順 | スキャンPDF (OCR) | 複雑な表 | LaTeX数式 ($/$$) | 料金・ライセンス |
|---|---|---|---|---|---|---|---|
| KolmoPDF | ページ全体 VLM | Web・API・Skill/MCP | ✅ 正確に線形化 | ✅ 標準内蔵 | ✅ GFM パイプ表 | ✅ インライン・ブロック | 登録時300P+毎日50P無料;2P/頁・PAYG $3/1000P |
| Docling (IBM) | レイアウト+TableFormer+OCR | ローカル Python (CPU/GPU) | ✅ 良好(図注要確認) | ✅ OCR 選択可 | ✅ 構造再現が高い | ⚠️ オプション有効化 | 無料・OSS(MIT) |
| Marker (Datalab) | Surya OCR+レイアウト+LLM任意 | ローカル Python (GPU推奨) | ✅ 非常に高い | ✅ 標準内蔵 | ✅ 良好 | ✅ LaTeX 出力 | コード Apache 2.0;重みは年商$5M未満無料 |
| MinerU | パイプライン+VLM 切替 | ローカル Python (GPU推奨) | ✅ 非常に高い | ✅ 100言語以上対応 | ✅ 非常に強い | ✅ LaTeX 出力 | MinerU Open Source License |
| Mathpix | 数式特化 OCR (.mmd) | Web・デスクトップ・API | ✅ 高い | ✅ 標準内蔵 | ⚠️ 密な表は弱め | ✅ 最高水準 | 無料枠少なめ・従量課金 |
| LlamaParse | クラウド Agentic パース | LlamaCloud / API | ✅ 高い(上位層) | ✅ 標準内蔵 | ✅ 強い | ✅ 良好 | 月次無料枠あり・従量課金 |
| PyMuPDF4LLM | フォント・座標ベース抽出 | ローカル Python (CPU) | ⚠️ 図の周辺で崩れ | ❌ OCR なし | ⚠️ 単純な表のみ | ❌ 文字化け | AGPL / 商用ライセンス |
| MarkItDown (Microsoft) | マルチフォーマット抽出 | ローカル Python / CLI | ❌ 列が混ざる | ❌ 外部OCR必要 | ❌ 平文化しやすい | ❌ 欠落 | 無料・OSS(MIT) |
| pdf2md.morethan.io | ブラウザ内テキスト層解析 | ブラウザ(送信不要) | ⚠️ 2段組が混在 | ❌ 非対応 | ❌ 崩壊 | ❌ 記号崩れ | 完全無料 |
| CloudConvert / iLovePDF | 汎用オンライン変換 | クラウド Web / API | ⚠️ 不安定 | ❌ 基本非対応/有料 | ⚠️ 崩れやすい | ❌ 記号崩れ | 日次無料枠あり |
検証方法とテスト文書(再現可能)
ベンチマーク数値の印象操作を避け、RAG やノート整理(Obsidian・Notion)で実際に問題になりやすい 3 種類の文書で挙動を検証しました。
- 2段組の学術論文(公開ダウンロード可): Vaswani et al., Attention Is All You Need(2017)。テストに使用した original.pdf と、KolmoPDF が出力した original.md をそのまま公開しています。
- スキャン書籍の章(テキスト層なしの画像 PDF): 傾き、ヘッダー・フッター、脚注を含むスキャン原稿。
- セル結合・ページ跨ぎのある決算・技術表: 行ラベルと数値列の対応が崩れやすい表。
※ 2・3 は著作権上非公開の社内サンプルです。Docling・Marker・MinerU・LlamaParse 等については 2026 年時点の公開仕様(CPU/GPU 要件やライセンス条件)も含めて整理しています。
実解析例:Attention Is All You Need(4ページ・6ページ)
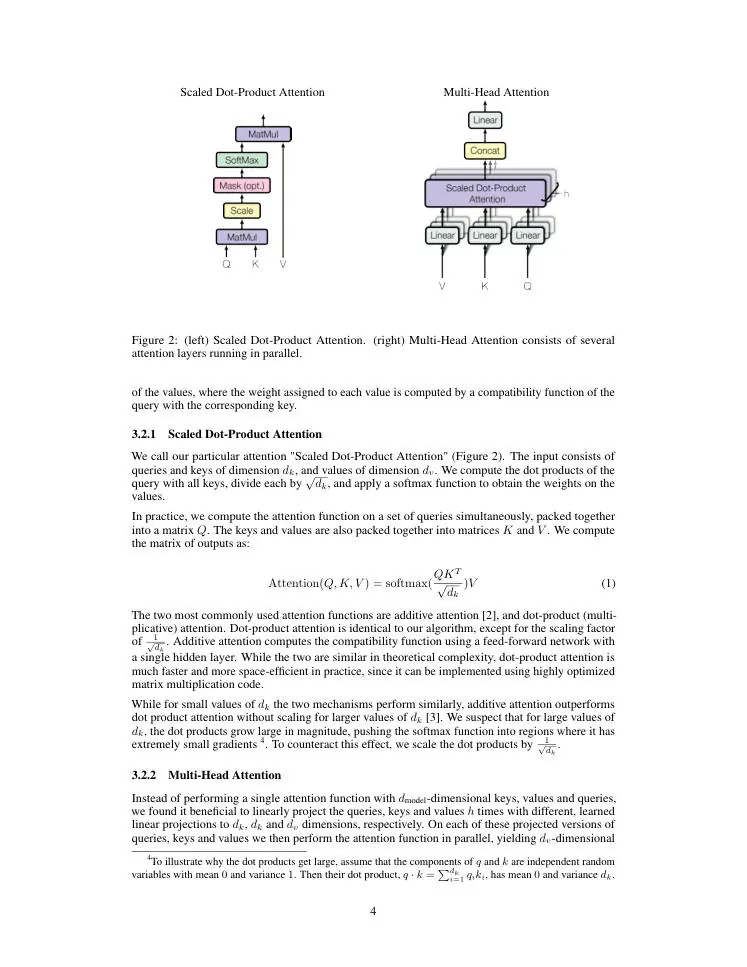
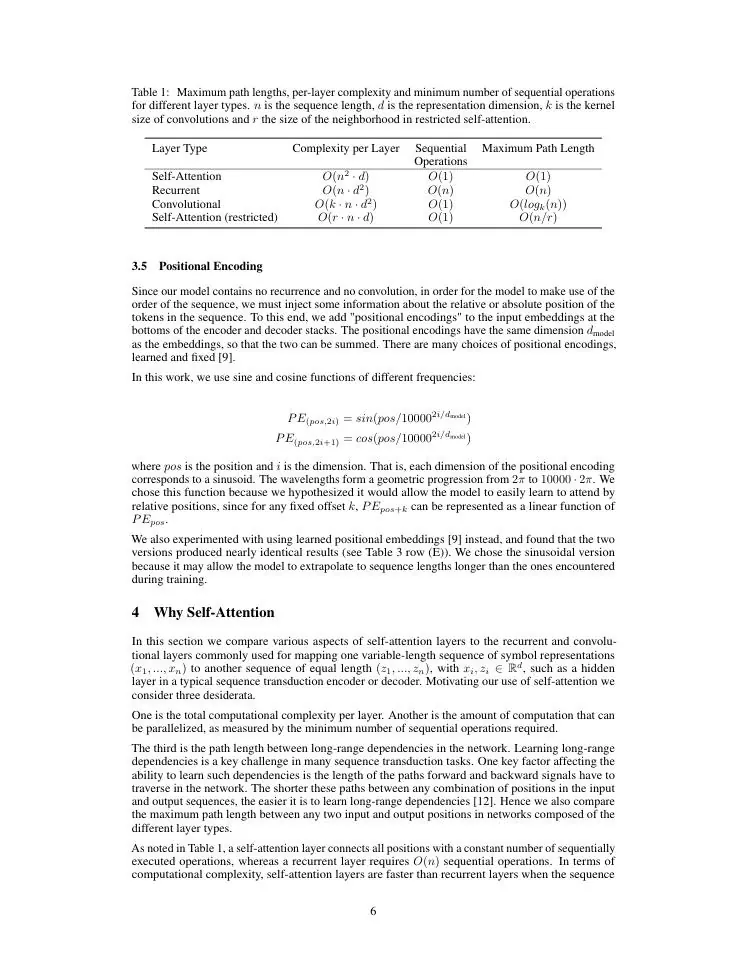
抽出された数式 1(LaTeX):
$$
\text{Attention}(Q, K, V) = \text{softmax}(\frac{QK^T}{\sqrt{d_k}})V
$$
抽出された Table 1(GitHub Flavored Markdown テーブル):
| Layer Type | Complexity per Layer | Sequential Operations | Maximum Path Length |
| :--- | :---: | :---: | :---: |
| Self-Attention | $O(n^2 \cdot d)$ | $O(1)$ | $O(1)$ |
| Recurrent | $O(n \cdot d^2)$ | $O(n)$ | $O(n)$ |
| Convolutional | $O(k \cdot n \cdot d^2)$ | $O(1)$ | $O(log_k(n))$ |
| Self-Attention (restricted) | $O(r \cdot n \cdot d)$ | $O(1)$ | $O(n/r)$ |
セル内のインライン数式 $O(n^2 \cdot d)$ まで壊れずに残るため、Obsidian での数式表示や RAG の構造化チャンク分割にそのまま利用できます。詳しい設定手順は 数式・表・2段組を保持して PDF を Markdown に変換する方法 をご覧ください。
各ツールの評価と向き・不向き
1. KolmoPDF — 環境構築なしで論文・スキャン・AIエージェント連携まで完結
KolmoPDF はページを画像として視覚的に理解する VLM 方式のため、デジタル PDF とスキャン PDF を同じ精度で処理できます。
- 強み: 2段組・3段組の正しい読み順、インライン/ブロック LaTeX 数式(
$/$$または\[...\])、結合セルを含む GFM 表(複雑な図表は画像出力も選択可)、脚注の分離、1回の処理で9言語への同時翻訳(3ポイント/ページ)に対応。1タスク最大 300 MB / 800 ページ まで扱えます。 - 開発者・AI 連携: 非同期 REST API(PDF 解析 API)に加え、Claude Code / Codex / Cursor 向けの公式 Skill(
npx skills add komoai2026/kolmopdf-skill)や MCP サーバー(@kolmopdf/mcp-server)も同じクレジット残高で利用できます。 - プライバシーと料金: アップロード文書は AI モデルの学習に一切使用しません(セキュリティ方針)。初回登録で 300ポイント(150ページ分) +毎日ログイン 50ポイント が付与され、都度払い(PAYG)は 1,000ポイント $3(有効期限なし)です。
- 注意点: クラウド処理のため完全オフライン環境には向きません。
2. Docling(IBM)— 商用でも使いやすい MIT ライセンス・CPU 対応
- 長所: MIT ライセンスで企業システムへ組み込みやすく、GPU がない CPU 環境でも動作します。TableFormer による表構造抽出と差し替え可能な OCR バックエンドが強力です。
- 注意点: 初回実行時にモデルダウンロードが必要で、数式を LaTeX 化する場合は追加オプションによる処理時間増に注意が必要です。
3. Marker / MinerU — 自社 GPU で大量処理するなら最有力
- Marker は GPU 環境での高速性と LaTeX 数式再現に優れます(ただしモデル重みは売上・資金調達 $5M 超で商用ライセンス要)。
- MinerU は多言語・日本語や中国語を含むスキャン文献に強い一方、VRAM 4〜8 GB 以上の GPU とまとまったディスク容量が前提になります。
4. Mathpix / LlamaParse — 用途特化のクラウド選択肢
- Mathpix は数式 OCR の精度が極めて高い反面、表の再現や無料枠の少なさがネックになりがちです。
- LlamaParse は LlamaIndex 連携に最適ですが、高精度な Agentic モードを使うとページ単価が上がりやすい点に留意が必要です。
5. PyMuPDF4LLM / MarkItDown / pdf2md — 軽量テキスト抽出
- PyMuPDF4LLM は綺麗なデジタル PDF の Python 前処理として最速クラスです(Python 実装コード解説)。
- MarkItDown は Office 書類・HTML・PDF を統一インタフェースで扱えますが、PDF の見出し構造や数式・表の再現は苦手です。
- pdf2md.morethan.io は単段組の簡単なデジタル PDF をブラウザだけで変換したい場合に便利です。
用途別のおすすめ選び方
- 論文・数式・表・スキャン PDF を環境構築なしで綺麗に変換したい: KolmoPDF PDF Markdown変換
- 社内の閉域網・CPU サーバーでライセンス制限なく運用したい: Docling(MIT)
- 自社 GPU で大量バッチをコストゼロで回したい: Marker または MinerU
- レイアウトそのままの日本語 PDF 翻訳が必要: KolmoPDF PDF翻訳(PDF翻訳の7つの方法も参照)
- 抽出した Markdown をそのまま Word(.docx)で提出したい: MarkdownをWordに変換
よくある質問(FAQ)
2段組の論文や数式が他ツールで崩れるのはなぜですか? 一般的な PDF 抽出ツールは、視覚的なレイアウトではなく PDF 内部のテキスト格納順を読み取るため、左右の段が混ざり、分数や添字が文字化けします。VLM ベースのツールはページ画像全体を見て読み順と LaTeX 構造を再構成します。
アップロードした PDF は AI の学習に使われますか? KolmoPDF ではアップロードされた PDF や解析後の Markdown を AI モデルの学習に利用したり第三者へ提供したりしません。ローカル完結が必須の場合は Docling 等のオープンソースをご利用ください。
Obsidian や RAG パイプラインにそのまま使えますか?
はい。# / ## / ### の見出し階層、GFM パイプ表、$...$ / $$...$$ 数式が標準形式で出力されるため、Obsidian への取り込みや LangChain / LlamaIndex のヘッダー分割(Chunking)にそのまま接続できます。