2026 年最佳 PDF 转 Markdown 工具深度对比:公式、复杂表格与扫描件实测(10 款评测)
KomoAI LLC · 更新于 · 首次发布 · 8 分钟阅读
先说结论: 如果只是把纯文本、单栏的数字 PDF 尽快变成文本,开源免费的 pymupdf4llm 或浏览器本地工具 pdf2md.morethan.io 几秒就能搞定;但只要文档里出现双栏排版、LaTeX 数学公式、合并单元格表格、脚注或纯图片扫描件,传统文本流解析就会立刻错行、丢公式。此时需要视觉或版面感知方案:想要免部署 GPU、即开即用的网页端 / REST API / AI Agent Skill(Claude Code、Cursor),首选 KolmoPDF PDF 转 Markdown;需要内网离线 CPU 部署选 Docling(MIT);自备 NVIDIA 显卡做免费批量解析选 MinerU 或 Marker;纯数学重度文档可选 Mathpix。
透明声明: KolmoPDF 是我们的自有产品。对于完全离线内网、自有 GPU 零成本批量跑库,或纯单栏简单 PDF,我们在文中也会如实指出开源或免费工具更合适的场景。
直接用真实论文验证: 下载我们的公开测试样本 original.pdf(Attention Is All You Need),对照 KolmoPDF 实际导出的 Markdown,或在 PDF 转 Markdown 工具页 亲自测试;若需直接阅读译文,也可使用 保留排版 PDF 翻译。
10 款主流 PDF 转 Markdown 工具对比总表(2026 年 11 月)
| 工具 | 核心架构 | 运行方式 | 双栏阅读顺序 | 扫描件 OCR | 合并单元格/跨页表格 | LaTeX 公式 ($/$$) | 费用与协议 |
|---|---|---|---|---|---|---|---|
| KolmoPDF | 全页视觉语言模型 (VLM) | 网页端、REST API、Skill/MCP | ✅ 顺序准确 | ✅ 原生支持 | ✅ GFM 管道表 | ✅ 行内与独立公式 | 注册送300积分+每日50;2积分/页;按量 $3/千分 |
| Docling (IBM) | 版面分析 + TableFormer + OCR | 本地 Python (CPU/GPU) | ✅ 稳定(偶有图注微偏) | ✅ 可插拔 OCR | ✅ 表结构极强 | ⚠️ 需开富化选项 | 免费开源(MIT) |
| MinerU | Pipeline + VLM 双后端 | 本地 Python (建议 GPU) | ✅ 很强 | ✅ 支持 100+ 语言 | ✅ 极强 | ✅ LaTeX 公式 | MinerU Open Source License |
| Marker (Datalab) | Surya OCR + 版面 + 可选 LLM | 本地 Python (建议 GPU) | ✅ 很强 | ✅ 内置 | ✅ 良好 | ✅ LaTeX 公式 | 代码 Apache 2.0;权重年营收<$5M 免费 |
| Mathpix | 视觉公式 OCR (.mmd) | 网页、桌面端、API | ✅ 很强 | ✅ 内置 | ⚠️ 密集财报偏弱 | ✅ 行业标杆 | 免费额度极少,按页付费 |
| LlamaParse | 云端 Agentic 多档位解析 | LlamaCloud / API | ✅ Agentic 档很强 | ✅ 内置 | ✅ 强 | ✅ 良好 | 每月免费额度 + 分档按页计费 |
| PyMuPDF4LLM | 文本流与字号启发式 | 本地 Python (CPU) | ⚠️ 遇插图易错序 | ❌ 无 OCR | ⚠️ 仅简单表格 | ❌ 符号乱码 | AGPL / 商业授权 |
| MarkItDown (微软) | 多格式统一抽取 | 本地 Python / CLI | ❌ 双栏交叉 | ❌ 需外接 OCR/LLM | ❌ 表格扁平化 | ❌ 丢失公式 | 免费开源(MIT) |
| pdf2md.morethan.io | 浏览器文本层解析 | 浏览器本地(不上传) | ⚠️ 双栏交错 | ❌ 无 OCR | ❌ 塌成纯文本 | ❌ 符号损坏 | 完全免费 |
| CloudConvert / iLovePDF | 通用在线格式平台 | 云端网页 / API | ⚠️ 一般 | ❌ 基础版无 | ⚠️ 经常塌陷 | ❌ 符号损坏 | 每日免费限次 |
测试方法与样本(可复现核验)
我们用科研、工程与金融 RAG 中最容易翻车的 3 类文档进行对比检验:
- 双栏学术论文(公开可下载验证): Vaswani et al., Attention Is All You Need(2017)。测试原文 original.pdf 与 KolmoPDF 实测输出 original.md 均已公开。
- 纯图片扫描书籍章节: 无可复制文本层,含轻微倾斜、页眉页脚与脚注。
- 跨页复杂财务报表: 含合并表头、跨页续表,需要行列数字严格对齐。
说明: 样本 2、3 因版权原因仅作内部基准测试,不作公开分发;Docling、MinerU、Marker、MarkItDown 与 LlamaParse 同时结合 2026 年现行版本的硬件依赖、授权协议与公开技术规格进行评估。
实测效果展示:Attention Is All You Need 第 4 页与第 6 页
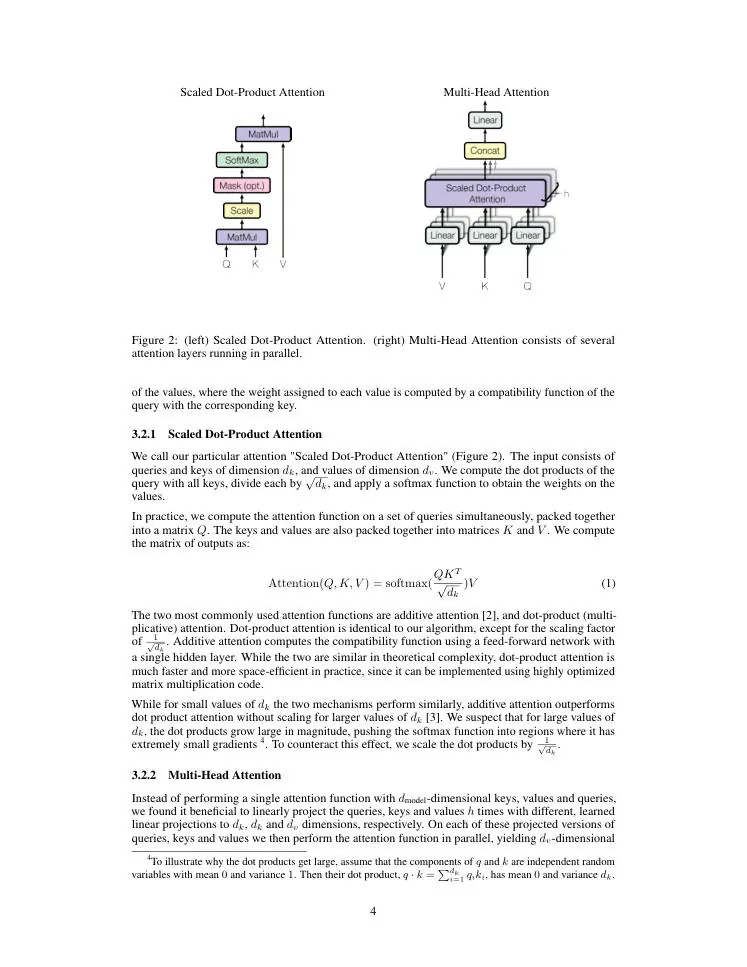
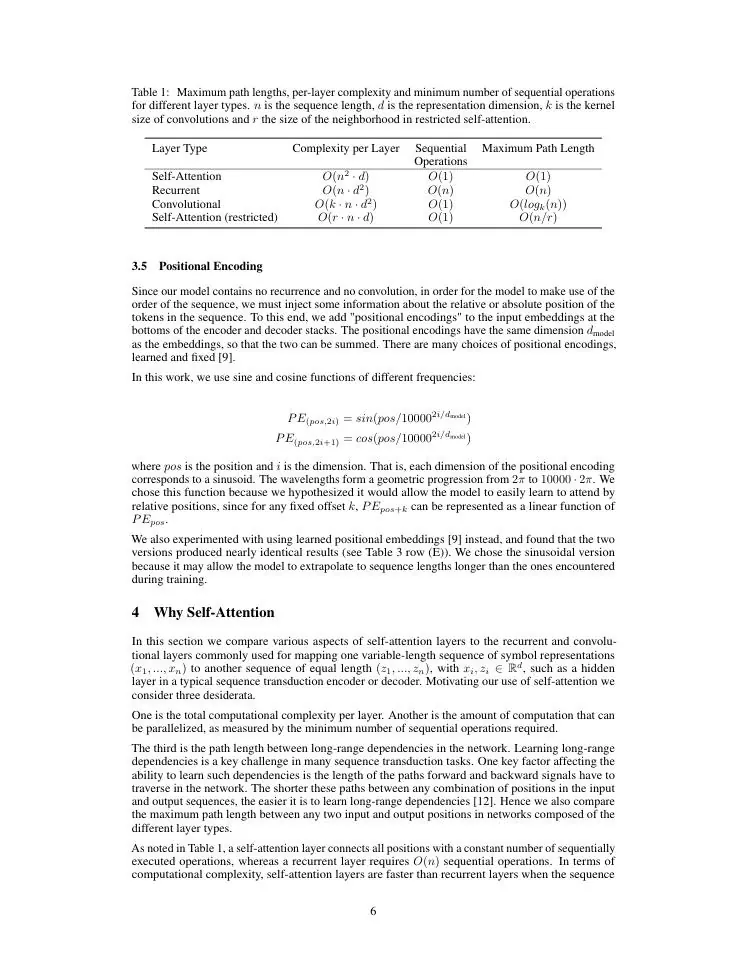
提取出的公式 1(标准 LaTeX):
$$
\text{Attention}(Q, K, V) = \text{softmax}(\frac{QK^T}{\sqrt{d_k}})V
$$
提取出的 Table 1(GitHub 风格 Markdown 管道表):
| Layer Type | Complexity per Layer | Sequential Operations | Maximum Path Length |
| :--- | :---: | :---: | :---: |
| Self-Attention | $O(n^2 \cdot d)$ | $O(1)$ | $O(1)$ |
| Recurrent | $O(n \cdot d^2)$ | $O(n)$ | $O(n)$ |
| Convolutional | $O(k \cdot n \cdot d^2)$ | $O(1)$ | $O(log_k(n))$ |
| Self-Attention (restricted) | $O(r \cdot n \cdot d)$ | $O(1)$ | $O(n/r)$ |
表格单元格内的 $O(n^2 \cdot d)$ 行内公式与独立公式均完整保留,直接放入 Obsidian、Notion 或 RAG 切片流水线即可渲染或检索。完整操作步骤可查看 PDF 转 Markdown 保留表格与公式实战教程。
10 款工具逐一解析
1. KolmoPDF — 免配显卡、兼顾论文精度与 AI Agent 集成的在线 VLM 方案
KolmoPDF 使用针对论文、教材与技术手册训练的视觉语言模型逐页理解版面,原生 PDF 与扫描件走同一条视觉识别链路,不依赖脆弱的文本流排序。
- 核心优势: 准确还原双栏/三栏阅读顺序、行内与独立 LaTeX 公式(支持
$/$$或\[...\])、合并单元格与跨页 GFM 表格(超复杂图表也支持切为图片表)、独立分离脚注与代码块语言标识,并支持同一次解析直接翻译为 9 种语言(带翻译 3 积分/页)。单任务支持高达 300 MB / 800 页。 - 开发者与 AI 工作流: 提供异步 PDF 解析 API(
POST /api/v1/jobs/parse),以及面向 Claude Code / Codex / Cursor 的官方 Skill(npx skills add komoai2026/kolmopdf-skill)和 MCP 服务(@kolmopdf/mcp-server),Web、API 与 MCP 共享同一积分余额。 - 隐私与定价: 上传的 PDF 与解析结果绝不用于训练 AI 模型(见 文件安全承诺)。新用户注册送 300 免费积分(可解析 150 页),每日签到再领 50 积分;按量购买 $3 / 1,000 积分永不过期。
- 局限: 需联网上传处理,不适用于完全物理隔离的离线内网。
2. Docling(IBM)— 协议最友好的纯 CPU / 内网开源首选
- 优点: 纯正 MIT 协议,不强制要求独立显卡即可在 CPU 上运行,内置表格结构识别(TableFormer)与可替换 OCR 引擎,无缝对接 LangChain / LlamaIndex。
- 局限: 首次运行需下载模型权重,大批量吞吐慢于轻量库;重度公式文档需额外开启公式增强选项。
3. MinerU — 中英文与扫描件表现突出的开源双模式方案
- 优点: 同时提供轻量 Pipeline 与 VLM 后端,支持 100+ 语种 OCR 与科研公式识别,在国内 RAG 社区生态丰富。
- 局限: 需较高本地硬件配置(VLM 模式建议 8 GB+ 显存与 20 GB+ 磁盘空间),商业嵌入前需核对其 MinerU Open Source License 条款。
4. Marker(Datalab)— GPU 环境下平衡速度与精度的开源工具
- 优点: 结合 Surya OCR 与版面识别,在 GPU 上速度较快,LaTeX 公式与插图抽取表现出色。
- 局限: 依赖较重(PyTorch/推理服务),模型权重协议对年营收或融资超过 500 万美元的商业团队要求单独授权。
5. Mathpix / LlamaParse — 垂直细分场景之选
- Mathpix 在纯数学公式 OCR 与
.mmd生态仍处第一梯队,但免费页数少、密集跨页表表现略逊。 - LlamaParse 与 LlamaIndex 生态绑定紧密,Agentic 模式对复杂版式与表单勾选效果好,但高阶档位单页成本上升较快。
6. PyMuPDF4LLM / MarkItDown / pdf2md / CloudConvert
- PyMuPDF4LLM: 纯数字单栏 PDF 的 Python 极速基线(代码见 Python PDF 转 Markdown 实战),但不支持扫描件与复杂公式。
- MarkItDown: 微软出品的 MIT 万能转 Markdown 工具,强在 Office/网页/音频多格式统一,但默认 PDF 路径不保留标题层级、表格与公式。
- pdf2md.morethan.io / CloudConvert / iLovePDF: 适合临时处理简单单栏数字文件,遇到科研论文与扫描件很容易错乱。
按场景快速选型
- 科研论文、技术书籍、扫描件、合并表格(不想折腾显卡): KolmoPDF PDF 转 Markdown(网页 / API / Skill)
- 内网隔离环境 / 要求严格 MIT 商用协议: Docling
- 自有 NVIDIA GPU 服务器做零单页成本批处理: MinerU 或 Marker
- 大量纯数字单栏 PDF 极速前置过滤: PyMuPDF4LLM(遇到扫描或复杂页再路由至 VLM API)
- 保留原 PDF 排版直接翻译成中文: KolmoPDF PDF 翻译(见 7 种 PDF 翻译方法对比)
常见问题(FAQ)
为什么大多数免费工具转双栏论文会串行、公式变乱码? 因为 PDF 底层记录的是字符绘制坐标而非语义段落。只读文本层的工具会按字节存储顺序拼字,把左右两栏混在一起,把分数和上下标拆成乱码。只有视觉语言模型(VLM)会像人眼一样先识别版面区域再重建 LaTeX。
上传到 KolmoPDF 的文档会用来训练模型吗? 不会。KolmoPDF 明确承诺不将用户上传的 PDF、提取文本或翻译内容用于 AI 模型训练或发送给第三方训练平台(详见 安全与隐私页)。
转换后的 Markdown 可以直接给 RAG、Obsidian 或转成 Word 吗?
可以。输出采用标准 GFM 格式,保留 # / ## / ### 标题层级(适合 RAG 按章节切片)、管道表格与 $ / $$ 公式;如需交稿 Word 文档,可直接用 Markdown 转 Word 导出保留真实标题样式与公式的 .docx。